
المقدمة
السلام عليكم،
خلال العقدين الأخيرين شهد مجال علم الجينوم (Genomics) تطورًا كبيرًا بفضل تقنيات التسلسل عالية الإنتاجية (Next-Generation Sequencing أو NGS)، التي سَمحت للباحثين بدراسة الحمض النووي بتكلفة أقل وبسرعة أكبر مقارنة بالتقنيات التقليدية. فبعد أن استغرق مشروع الجينوم البشري (Human Genome Project) أكثر من عشر سنوات واحتاج إلى استثمارات بمليارات الدولارات، أصبح من الممكن اليوم تحديد تسلسل الجينوم البشري بصفة شبه كاملة خلال فترة قصيرة نسبيًا وبتكلفة لا تتجاوز في بعض تقنيات السَلسَلة بضع مئات من الدولارات، دون احتساب جميع تكاليف تحضير العينات والتحليل والتخزين.
لكن الحصول على تسلسل الجينوم لا يمثل سوى المرحلة الأولى. فالتحدي الحقيقي يكمن في كيفية معالجة ملايين أو مليارات القراءات الجينية وتحويلها إلى معلومات بيولوجية يمكن الاستفادة منها في الأبحاث الطبية.
في هذا المقال سوف نحاول التعرف على تقنية تسلسل الجينوم الكامل, Whole-Genome Sequencing (WGS)، ونشرح أهم مراحل تحليل البيانات الناتجة عنها، وصيغ الملفات المستعملة، والأدوات الشائعة، ثم نلقي نظرة على أبرز مشاريع الجينوم البشري في العالم العربي.
1. ما المقصود بتسلسل الجينوم الكامل (WGS)؟
يحتوي الجينوم البشري على نحو 3.1 مليار زوج من القواعد النيتروجينية، وهو يحمل المعلومات الوراثية التي تساهم في تحديد خصائص الإنسان ووظائف خلاياه، إضافة إلى قابليته للإصابة ببعض الأمراض. ورغم التشابه الكبير بين جينومات البشر، فإننا نجد ملايين الاختلافات الوراثية (Genetic Variants) بين أي شخصين. قد لا يكون لمعظم هذه الاختلافات تأثير صحي او خلقي واضح، لكن قد يرتبط بعضها بأمراض وراثية، أو يؤثر في الاستجابة للأدوية، أو يساهم في اختلاف بعض الصفات البيولوجية بين الأفراد.
تسمح تقنية Whole-Genome Sequencing (WGS)، أو تسلسل الجينوم الكامل، بدراسة معظم تسلسل الحمض النووي للفرد، بما يشمل المناطق المشفرة للبروتينات (Coding Regions) والمناطق غير المشفرة (Non-coding Regions)، مثل الإنترونات والمناطق التنظيمية. ويختلف ذلك عن تسلسل الإكسوم الكامل (Whole-Exome Sequencing أو WES)، الذي يركز أساسًا على المناطق المشفرة للبروتينات، والتي لا تشكل سوى نحو 1–2% من الجينوم البشري.
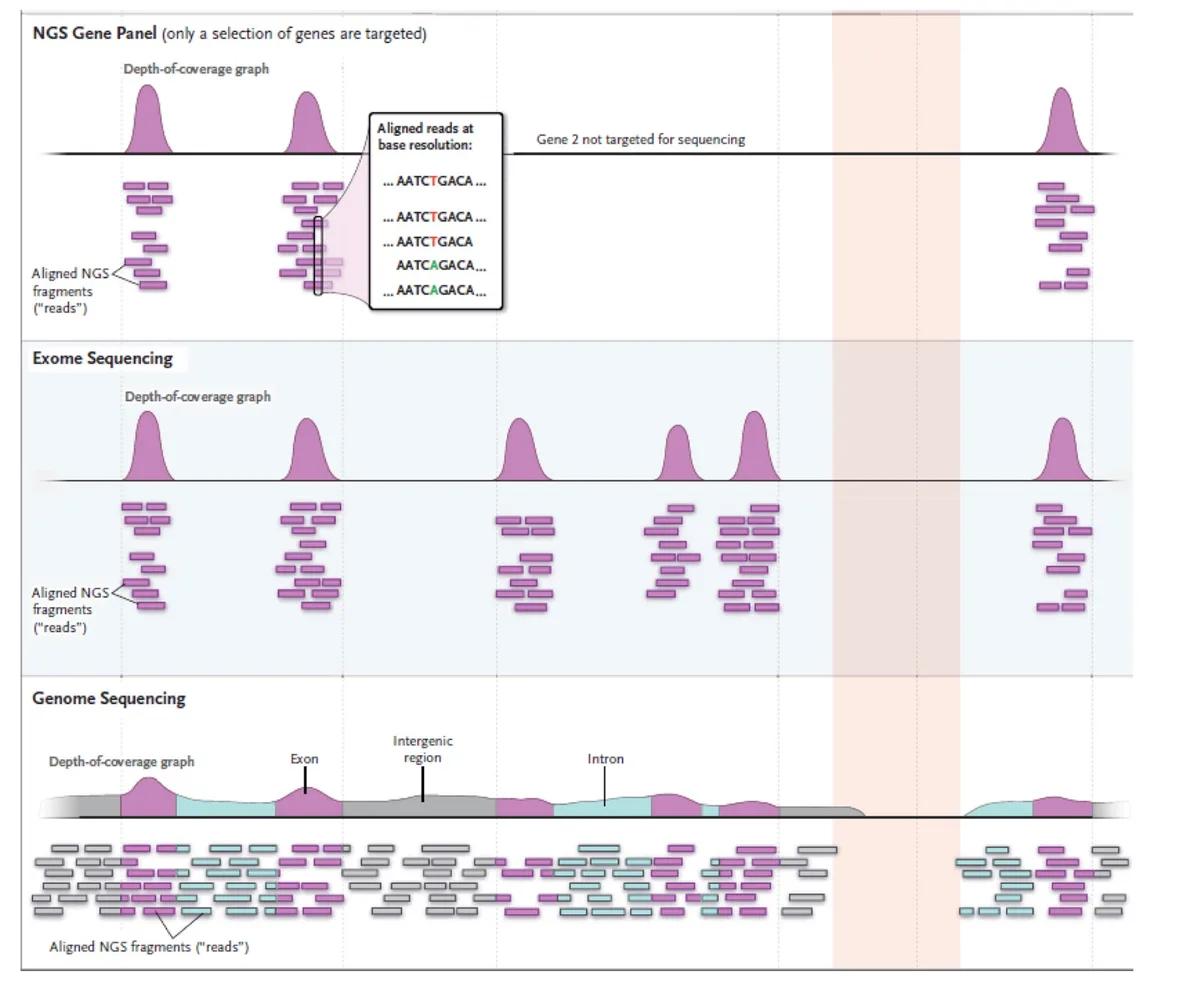
مصدر الصورة (هنا)
2. ما الهدف من تسلسل الجينوم الكامل؟
توجد العديد من التطبيقات البحثية والطبية لهذه التقنية، من أهمها:
- دراسة الأمراض الوراثية: البحث عن الطفرات الجينية التي قد تكون مسؤولة عن أمراض نادرة، خاصة لدى المرضى الذين لم يتمكن الأطباء من تشخيص حالاتهم بالطرق التقليدية.
- أبحاث السرطان: تحديد المتغيرات المكتسبة في الخلايا السرطانية (Somatic Variants)، وفهم بعض الآليات التي تساهم في تطور الأورام.
- الدراسات الجماعية (Population Genomics): دراسة التنوع الوراثي بين الأفراد والمجموعات السكانية، وفهم التاريخ السكاني والهجرات والقرابة الوراثية.
- دراسات الارتباط الجيني (GWAS): البحث عن العلاقات بين المتغيرات الوراثية والصفات أو الأمراض المعقدة، مثل السكري وأمراض القلب.
- الطب الدقيق (Precision Medicine): الاستفادة من المعلومات الجينومية، إلى جانب البيانات السريرية، لتحسين التشخيص واختيار العلاجات المناسبة لبعض المرضى.
ومن أهم مزايا WGS أنها لا تقتصر على دراسة الجينات المعروفة فقط، بل تتيح أيضًا تحليل المناطق غير المشفرة، واكتشاف أنواع مختلفة من المتغيرات الوراثية، بما في ذلك بعض التغيرات البنيوية (Structural Variants) التي يصعب دراستها باستخدام تقنيات أكثر استهدافًا.
لكن رغم تسميتها «تسلسل الجينوم الكامل»، فإن هذا لا يعني بالضرورة أننا نستطيع قراءة جميع مناطق الجينوم أو اكتشاف كل المتغيرات بدقة متساوية. فبعض المناطق شديدة التكرار أو التعقيد لا تزال تمثل تحديًا، خصوصًا عند استعمال تقنيات السَلسلة القصيرة.
3. كيف نقوم بتحليل بيانات WGS؟
بعد الانتهاء من عملية التسلسل، نحصل على كمية كبيرة من البيانات الخام التي يجب معالجتها باستخدام مجموعة من الأدوات الحاسوبية. لن نتطرق هنا إلى شرح تقنيات التسلسل أو تفاصيل ملفات FASTQ، لأنها نوقشت في مقالات سابقة في موقعنا، بل سنركز على الخطوات التي تحول هذه البيانات إلى قائمة من المتغيرات الوراثية القابلة للتحليل.
تتبع معظم مسارات تحليل WGS البشري المعتمد على الجينوم المرجعي ثلاث مراحل رئيسية:
- المعالجة الاولية للبيانات (Data Preprocessing): ويتم خلالها معالجة القراءات الجينية ومحاذاتها مع الجينوم المرجعي والتأكد من جودتها.
- اكتشاف المتغيرات الوراثية (Variant Calling): و يتم خلالها اكتشاف الاختلافات الوراثية بين الجينوم الذي نقوم بدراسته والجينوم المرجعي.
- تنقية المتغيرات الوراثية وتوصيفها (Variant Filtering and Annotation): وتشمل تقييم جودة المتغيرات المكتشفة واستبعاد النتائج غير الموثوقة أو المتغيرات ذات الجودة الضعيفة، ثم إضافة معلومات عن مواقعها الجينية وتأثيراتها الوظيفية ومدى انتشارها بين السكان وارتباطها المحتمل بالأمراض عن طريق المقارنة مع قواعد بيانات مختلفة.
4. المسار العام لتحليل بيانات WGS
يوضح المخطط أسفله اهم مراحل تحليل بيانات التسلسل المتكامل وصولا إلى التطبيقات البحثية والسريرية
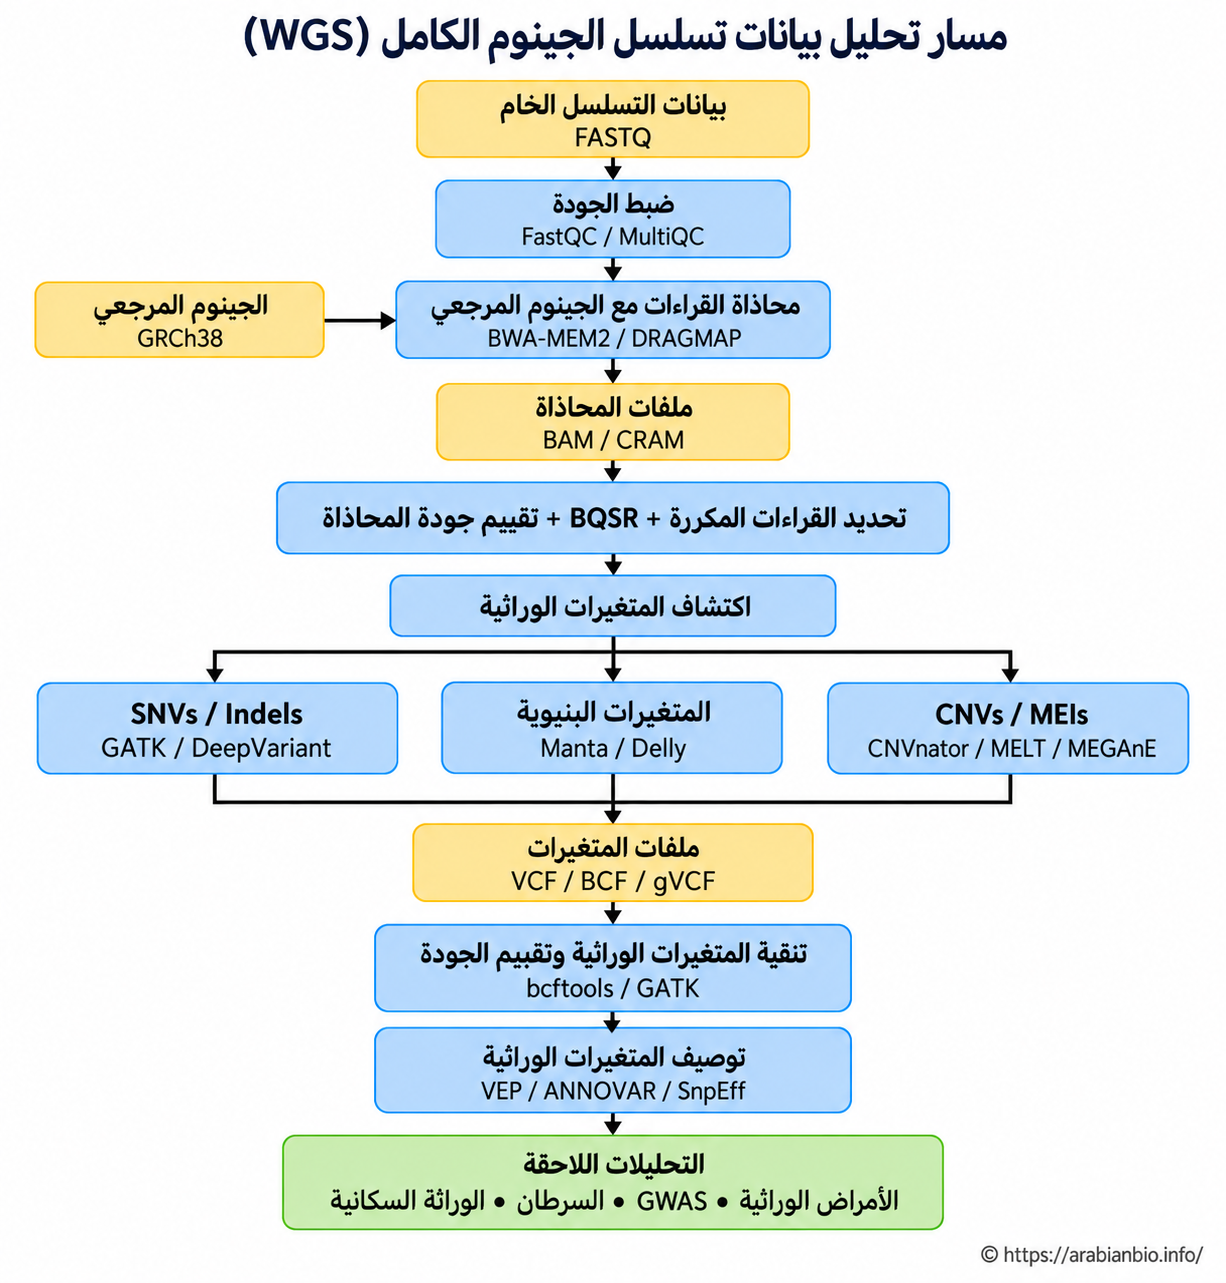
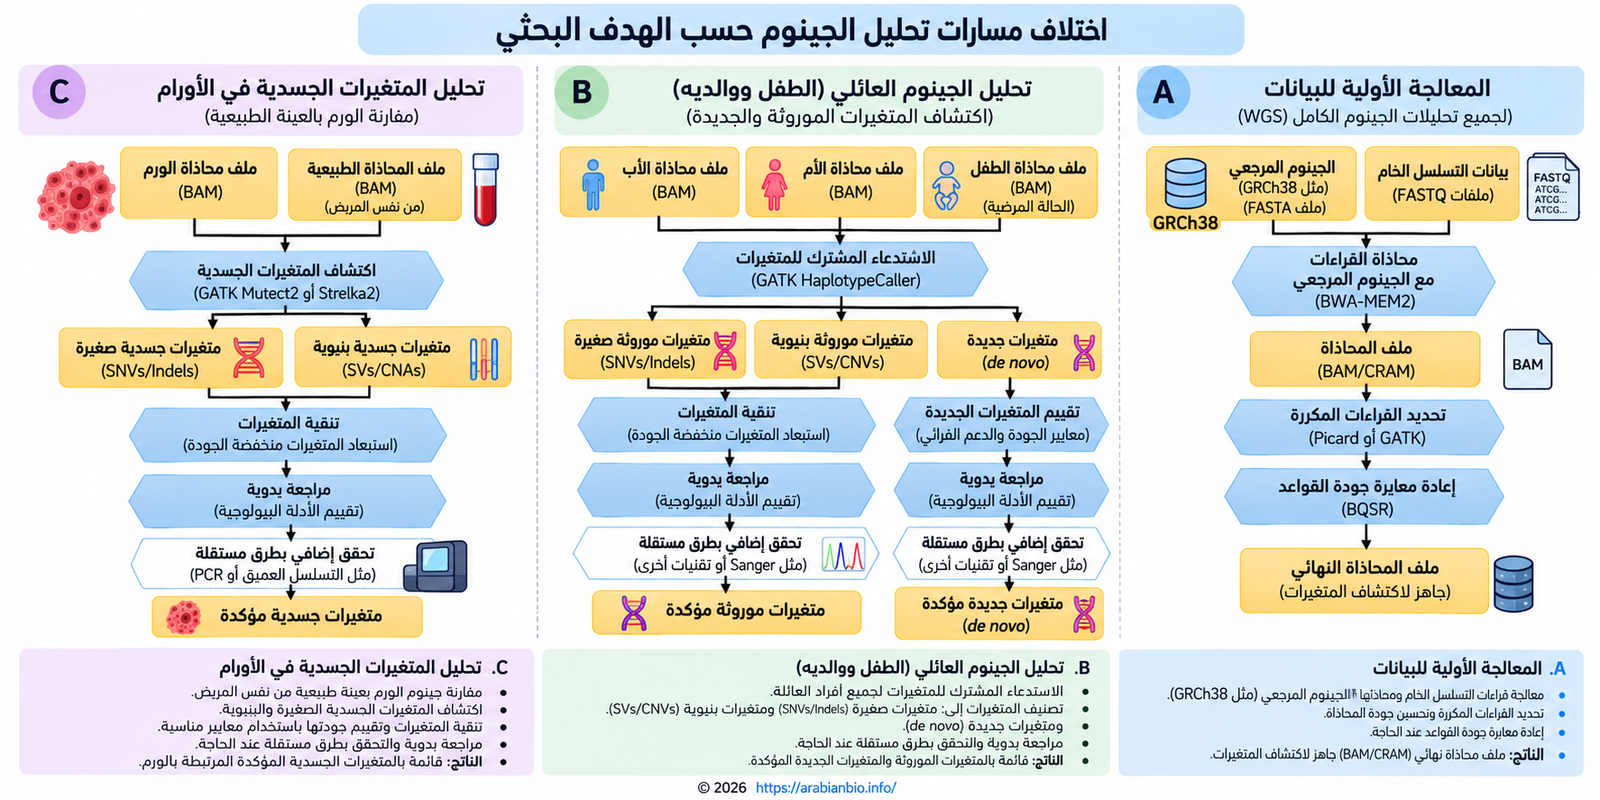
تختلف بعض تفاصيل هذه الخطوات حسب الهدف من الدراسة. فعلى سبيل المثال، عند تحليل جينومات آلاف الأشخاص، يمكن استعمال Joint Genotyping للحصول على مجموعة متسقة و موحدة من الأنماط الجينية عبر جميع العينات. أما عند دراسة مرض وراثي نادر، فقد نقوم بتحليل جينوم المريض ووالديه (Trio Analysis)، للتمييز بين المتغيرات الموروثة والمتغيرات التي يُحتمل أنها ظهرت لأول مرة لدى المريض (De novo Variants). وفي دراسات السرطان، يمكن مقارنة جينوم الورم بعينة طبيعية من المريض نفسه، بهدف اكتشاف المتغيرات الجسدية المكتسبة.
كذلك لا تستطيع أداة واحدة اكتشاف جميع أنواع المتغيرات الوراثية؛ لذلك تُستخدم برامج متخصصة للمتغيرات البنيوية (structural variants ،SVs) ، وتغيرات عدد النسخ،Copy Number Variants (CNVs) ، و العناصر الوراثية المتنقلة (Mobile Element Insertions).
5. هل الجينوم المرجعي يمثل التنوع الوراثي لجميع البشر؟
في معظم مراحل التحليل السابقة كنا نقوم بمحاذاة السلاسل الجينومية مع جينوم مرجعي (Reference Genome)، مثل GRCh38. لكن ما هو هذا الجينوم المرجعي؟ وهل يمثل فعلًا التنوع الوراثي للبشر؟
لفهم المشكلة، يجب العودة قليلًا إلى مشروع الجينوم البشري (Human Genome Project)، الذي أطلق في عام 1990 وأنتج أول مسودة واسعة للجينوم البشري عام 2001، قبل الإعلان عن اكتمال المشروع الأساسي عام 2003. كانت هذه المبادرة من أهم الإنجازات العلمية في علم الوراثة، لأنها وفرت تسلسلًا مرجعيًا يمكن للباحثين استعماله لدراسة مواقع الجينات والمتغيرات الوراثية.
لكن الجينوم المرجعي ليس متوسطًا وراثيًا لجميع البشر.فعلى سبيل المثال، يعتمد إصدار GRCh38 على تسلسلات مأخوذة من عدة أفراد، مع مساهمة كبيرة من جينوم فرد واحد. حيث انه جاء نحو 70% من التجميع المرجعي الأساسي من مكتبة جينومية تُعرف باسم RP11، تعود إلى متبرع واحد مجهول الهوية، بينما جاءت الأجزاء الأخرى من مكتبات جينومية متعددة. وبالتالي لا يمكن لتسلسل مرجعي خطي واحد أن يمثل جميع الأليلات والتغيرات البنيوية الموجودة في المجموعات البشرية المختلفة.
5.1 مشكلة الانحياز نحو الجينوم المرجعي (Reference Bias)
رغم أن البشر يتشابهون في معظم تسلسل الحمض النووي، فإن كل فرد يحمل ملايين المتغيرات الوراثية التي تميزه عن غيره. لنفترض أن منطقة معينة في الجينوم تحتوي على تركيب وراثي شائع لدى مجموعة سكانية ما، لكنه مختلف بصورة كبيرة عن التسلسل الموجود في GRCh38. عند محاولة محاذاة القراءات القادمة من هذه المنطقة، قد تواجه بعض البرامج صعوبة في تحديد مواقعها الصحيحة، وقد يؤدي ذلك إلى انخفاض جودة المحاذاة، أو إلى فقدان بعض المتغيرات. تسمى هذه الظاهرة ب Reference Bias، ويظهر تأثيرها بصورة خاصة في المناطق الجينومية المعقدة، مثل المناطق ذات التكرارات الكثيرة والتغيرات البنيوية الكبيرة.
5.2 مثال: مشروع Human Pangenome
لمعالجة بعض هذه المشكلات، ظهر مفهوم الجينوم الشامل (Pangenome)، الذي يهدف إلى تمثيل التنوع الوراثي باستخدام مجموعة من الجينومات بدل الاعتماد على تسلسل مرجعي خطي واحد. وفي عام 2023، نشر مشروع Human Pangenome Reference Consortium أول مسودة لجينوم شامل بشري اعتمادًا على تجميعات جينومية عالية الجودة من 47 فردًا ذوي خلفيات وراثية متنوعة. وكشفت الدراسة عن نحو 119 مليون قاعدة من التسلسلات المتغيرة غير الممثلة في المرجع GRCh38، بالإضافة إلى أكثر من ألف تضاعف جيني. وأظهرت كذلك أن استخدام مرجع Pangenome يمكن أن يحسن اكتشاف بعض أنواع المتغيرات مقارنة بالاعتماد على GRCh38 وحده.
هذا لا يعني أن المرجع التقليدي لم يعد مفيدًا، بل إن المراجع الأكثر تنوعًا قد تساعد على تقليل بعض الانحيازات وتحسين دقة التحليل.
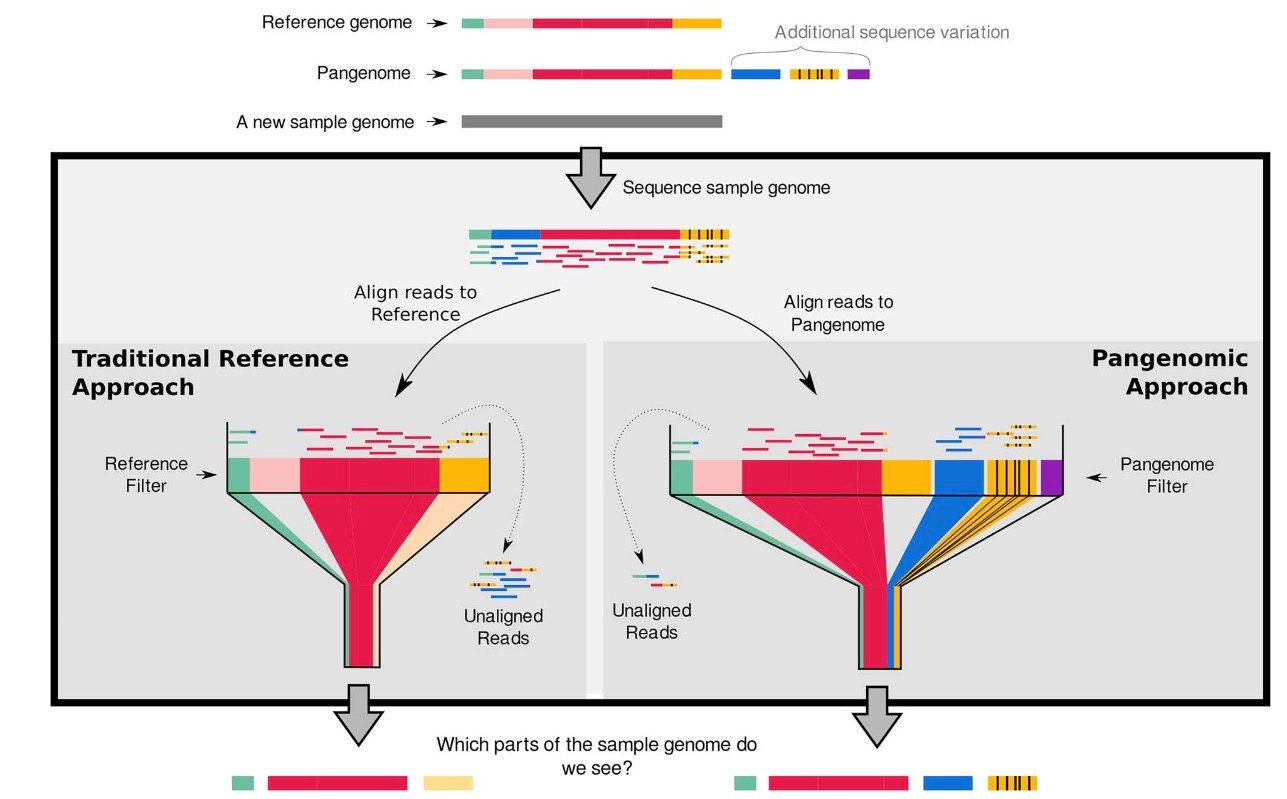
مصدر الصوره هنا
5.3 مشكلة أخرى: نقص تمثيل بعض المجموعات السكانية في قواعد البيانات
من المهم هنا التمييز بين مشكلتين مختلفتين:
الأولى هي Reference Bias، الناتجة عن محدودية تمثيل التنوع الوراثي في التسلسل المرجعي المستخدم للمحاذاة, ،و الثانية هي Population Representation Bias، الناتجة عن عدم تمثيل المجموعات السكانية المختلفة بصورة متوازنة في قواعد بيانات المتغيرات الوراثية والدراسات الجينومية. فعلى سبيل المثال، قد نجد متغيرًا وراثيًا نادرًا للغاية في قاعدة بيانات عالمية، لكنه شائع نسبيًا لدى مجموعة سكانية معينة لم تُمثل بصورة كافية في تلك القاعدة. إذا اعتمدنا على قواعد البيانات العالمية وحدها، فقد نبالغ في تقدير أهمية هذا المتغير، خصوصًا عند دراسة الأمراض الوراثية النادرة.
وتكتسب هذه المسألة أهمية كبيرة في منطقة الشرق الأوسط وشمال أفريقيا، التي تتميز بتاريخ سكاني معقد وتنوع وراثي تأثر بالهجرات والاختلاط السكاني والعزلة النسبية لبعض المجموعات عبر فترات تاريخية مختلفة.ولهذا لا يكفي فقط تحسين الجينوم المرجعي، بل نحتاج أيضًا إلى قواعد بيانات سكانية متنوعة تحتوي على معلومات عن تكرار المتغيرات والصفات السريرية المرتبطة بها، ومن هنا تأتي أهمية مشاريع الجينوم الوطنية التي بدأت تظهر في عدة دول عربية.
6. مشاريع الجينوم البشري في العالم العربي
شهدت منطقة الشرق الأوسط وشمال أفريقيا خلال السنوات الأخيرة إطلاق العديد من المشاريع الوطنية التي تهدف إلى دراسة التنوع الجيني للسكان والاستفادة منه في الأبحاث الطبية والطب الدقيق. تكتسب هذه المشاريع أهميتها من كون العديد من قواعد البيانات الجينومية العالمية لا تمثل بصورة متوازنة التنوع الوراثي الموجود لدى جميع المجموعات السكانية. ويمكن أن يساعد تطوير قواعد بيانات إقليمية في تحسين تفسير المتغيرات الوراثية النادرة ودراسة التاريخ السكاني والصفات المرتبطة بالأمراض.
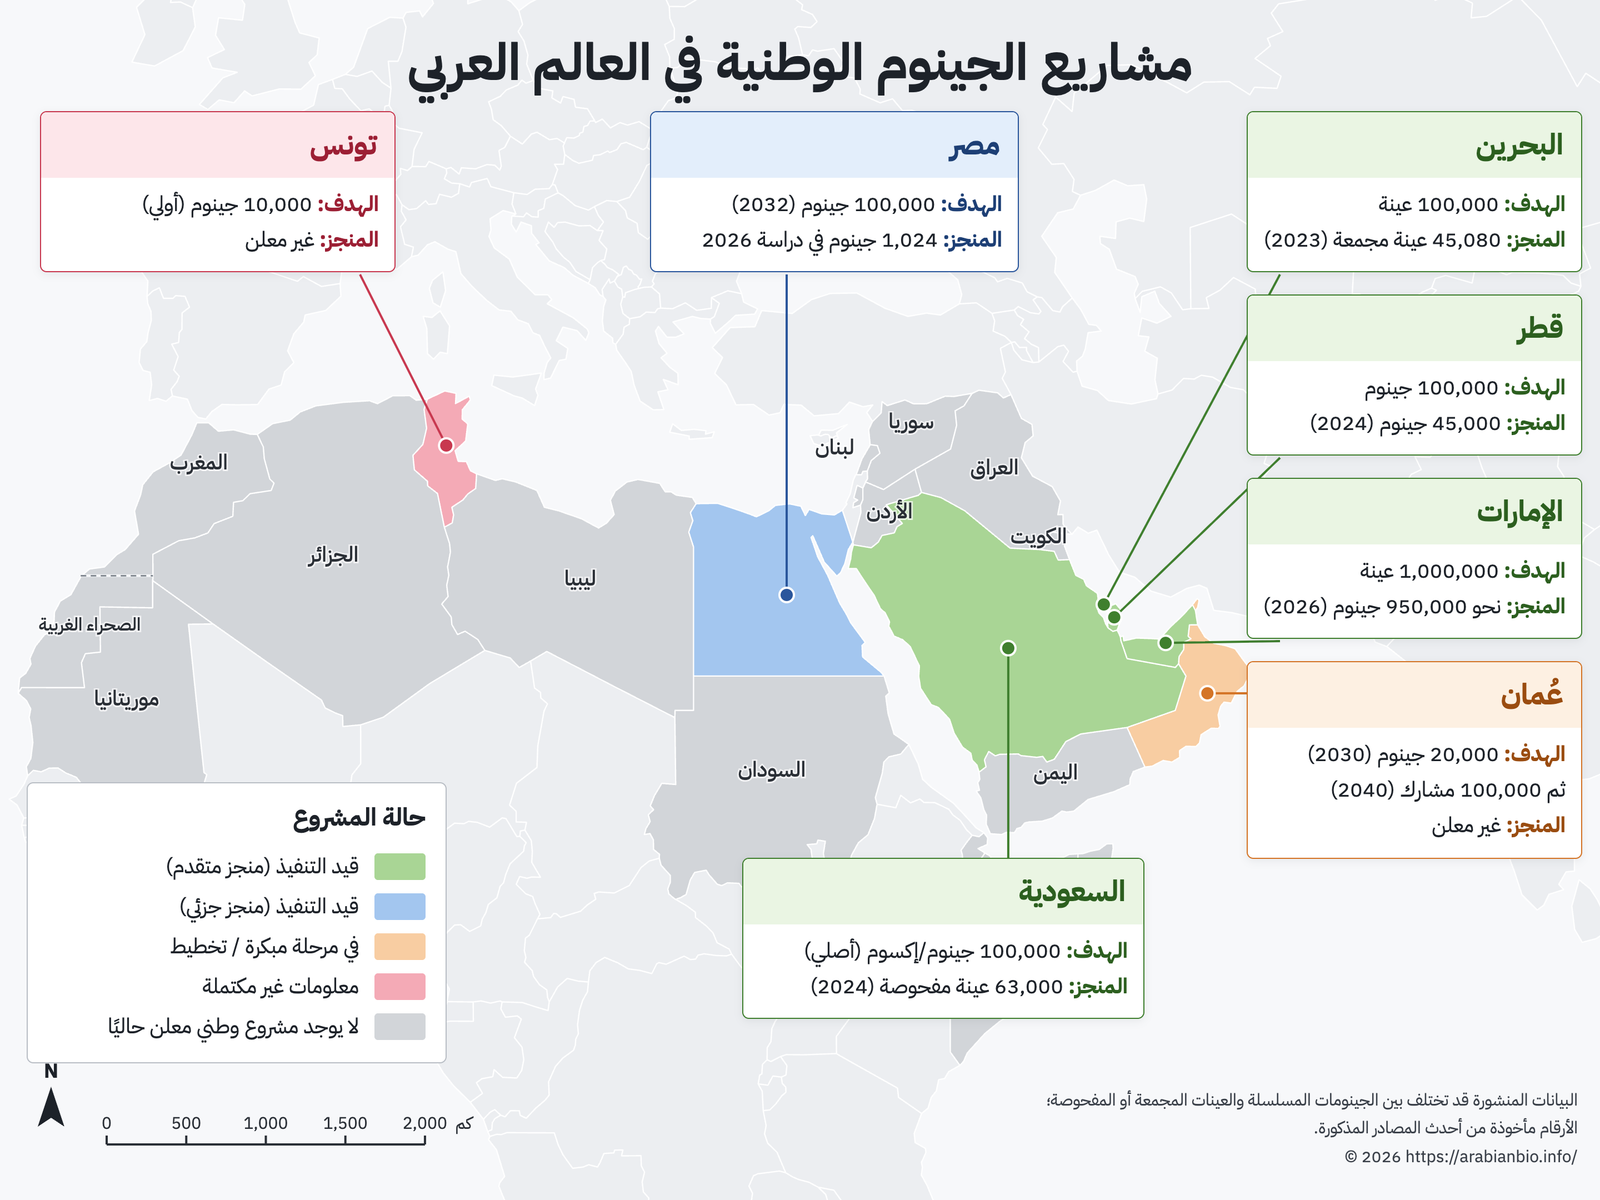
|
الدولة |
البرنامج |
الهدف المعلن |
الإنجاز المنشور |
|---|---|---|---|
|
قطر |
Qatar Genome Programme |
100,000 جينوم |
نحو 43,000 جينوم، نشرة 2025 |
|
السعودية |
Saudi Genome Program |
100,000 تسلسل جينومي/إكسومي، هدف أصلي |
63,000 عينة مفحوصة، 2024 |
|
الإمارات |
Emirati Genome Programme |
مليون عينة |
نحو 950,000 جينوم، 2026 |
|
البحرين |
Bahraini Genome Programme |
100,000 عينة |
45,080 عينة مجمعة، 2023 |
|
مصر |
Egyptian Genome Project |
100,000 جينوم بحلول 2032 |
1,024 جينوم في دراسة 2026 |
|
تونس |
Genome Tunisia |
10,000 جينوم في المرحلة الأولية |
لم يُحدَّد هنا |
|
عُمان |
Oman Genome |
20,000 جينوم بحلول 2030 |
لم يُحدَّد هنا |
المصادر والمراجع
- National Human Genome Research Institute (NHGRI). Human Genome Project: Overview and History.
- Broad Institute. GATK Best Practices.
- Ewels et al. (2020). The nf-core framework for community-curated bioinformatics pipelines. Nature Biotechnology.
- nf-core. Sarek: A pipeline for whole-genome and whole-exome sequencing analysis.
- Genome Reference Consortium (GRC). Frequently Asked Questions — Human Reference Genome.
- Liao, W.-W., et al. (2023). A draft human pangenome reference. Nature, 617, 312–324.
- Matthews, C. A., et al. (2024). A gentle introduction to pangenomics. Briefings in Bioinformatics, 25(6), bbae588.
- Angrist, M. (2024). Viewpoint: The story of RP11, whose DNA mostly defines the first genetic blueprint of humanity. Genetic Literacy Project.
- Kiefer, P. (2021). The benchmark for human diversity is based on one man's genome. A new tool could change that. Popular Science.
- gnomAD Consortium. Genome Aggregation Database.
- Qatar Foundation (2025). Qatar Genome Programme — Precision Health Factsheet.
- Saudi Vision 2030 (2024). Saudi Genome Program.
- Emirates Genome Council. Emirati Genome Programme.
- Department of Health – Abu Dhabi (2026). Trusted Research Environment for Genomic and Health Research.
- Bahrain Ministry of Health. Bahraini National Genome Programme.
- Egyptian Ministry of Higher Education and Scientific Research (2026). Egyptian and Ancient Egyptian Reference Genome Project.
- Nature Communications (2026). Advancing global genomic equity: making a case for national genome projects in Africa.
- Oman Ministry of Health (2026). Health Ministry Lays Foundation Stone for Genome Oman.
- ScienceDirect (2026). Scientific article — PII: S0003426626000740.