
حزمة Biostrings
عند تحميل لغة الآر تأتي مزودة ببعض الدوال للتعامل مع السلاسل الحرفية (Strings) العادية دون الأخذ بعين الاعتبار هل هي سلسلة بيولوجية أم فقط سلسلة حرفية عادية كما هو الحال في كافة اللغات الأخرى. فباستعمال دوال لغة الآر الأصلية يمكنك القيام بكل العمليات المعروفة من قلب و قص و بحث على جملة توافق قالبا من القوالب عن طريق استعمال التعابير القياسية (Regular expressions), ... إلخ. لكن عند الوصول إلى التعامل مع السَلاسل الجينومية سوف تلاحظ أن هذه الدوال لا تكفي وحتى وان كانت كافية فستلاحظ انها غير ملائمة في حالة البيانات الكبيرة. يعود هذا إلى عدة أسباب من بينها :- ان الخوارزميات مصممة للتعامل مع جمل ذات ابجديات كبيرة (26 حرف + الارقام + الرموز الخاصة) بينما تتكون السلال البيولوجية من ابجدية بسيطة 4 حروف بالنسبة للـ DNA أو الـ RNA و 20 حرفا بالنسبة للبروتين بالاضافة لحرف N الذي يدل ان الصيغة غير محددة.
- عملية مطابقة السلاسل البيولوجية تعتمد على مبدا مختلف عن عمليات المطابقة في السلاسل الحرفية, حيث أنها تأخذ بعين الاعتبار مبدا الادراج (Insertion) و الحذف (Deletion) وعدد الحروف الغير متطابقة ( mismatch count),... إلخ. لهذا تم تصميم خوارزميات لهذا الغرض كخوارزمية سميث و واترمان المشهورة.
أساسيات التعامل مع حزمة Biostrings
في لغة الآر يمكن استعمال حزمة Biostrings التي توفر بيئة متطورة تسمح بالتعامل مع السلاسل حيث تتوفر على العديد من الخوازميات السريعة و الكائنات لحواية السلاسل بطريقة ذكية لاستعمال الذاكرة وغيرها من المرافق، للتعامل السريع مع مجموعة كبيرة من السلاسل البيولوجية. تٌعَرِف حزمة Biostrings خمسة فئات (Classes) أساسية:| XString | وهي الفئة القاعدية التي ترث منها كل الفئات الأخرى وهي فئة افتراضية ولا يمكن انشاء كائنات منها. |
| BString | فئة فرعية تسمح بالتعامل مع كل أنواع السلاسل ( البيولوجية أو السلاسل العادية) |
| DNAString | فئة فرعية للتعامل مع سلاسل الحمض النووي |
| RNAString | فئة فرعية للتعامل مع سلاسل الحمض النووي الريبوزومي |
| AAString | فئة فرعية للتعامل مع السلاسل البروتينية ( سلاسل الأحماض الأمينية) |
يمكن انشاء كائنات من هذه الفئات كالتالي:
library(Biostrings)
bs <- BString("This is a normal string") #  BString انشاء كائن
ds <- DNAString("GCAAAGT-TT-C") # DNAString انشاء كائن
rs <- RNAString("GCAAAGU-UU-C") # RNAString انشاء كائن
rs2 <- RNAString(ds) # RNAString إلى DNAString تحويل
aas <- AAString(ds) # AAString انشاء كائنيتم التعامل مع هذه الكائنات وكانك تتعامل مع جدول حروف حيث يمكن حساب الطول وقراءة الحروف باعطاء فقط رقم الحرف كما هو مبين في المثال:
ds <- DNAString("GCAAAGT-TT-C")
length(ds)
# [1] 12

ds[1:3]
# 3-letter "DNAString" instance
#seq: GCA

ds[3:1]
# 3-letter "DNAString" instance
#seq: ACG

alphabetFrequency(ds)
#A C G T M R W S Y K V H D B N - + .
#3 2 2 3 0 0 0 0 0 0 0 0 0 0 0 2 0 0

head(trinucleotideFrequency(ds))
#AAA AAC AAG AAT ACA ACC
#  1   0   1   0   0   0
في حالة إذا ما أردت التعامل مع مجموعة من السلاسل وليس سِلسلة واحدة فقط يمكنك استعمال الكائنات : DNAStringSet , RNAStringSet , AAStringSet و BStringSet. من بين مزايا هذه الكائنات هو انها تمكنك من القيام بنفس العملية على مجموعة من السلاسل مرة واحدة دون كتابة كود معقد. مثلا في بعض الحالات تكوم نوعية سَلْسَلة الجزيئات القاعدية في مؤخرة كل سلسلة رديئة (phred-score < 20) فنقوم بحذف مثلا العشر جزيئات القاعدية الأخيرة من كل سلسلة باستعمال أمرsubseq.
DNAs <- c("ACCT-NACG", "ACGTTCGA","TCACCGAGACTTACGAC")
dnaSet <- DNAStringSet(DNAs)
dnaSet
#  A DNAStringSet instance of length 3
#    width seq
#[1]     9 ACCT-NACG
#[2]     8 ACGTTCGA
#[3]    17 TCACCGAGACTTACGAC

#يمكن القيام بعمليات على مجموعة من السلاسل  مع بعض
# مثلا ناخذ الخمس جزيئات القاعدية الأولى
subseq(dnaSet,start=1,end=5)
#  A DNAStringSet instance of length 3
#    width seq
#[1]     5 ACCT-
#[2]     5 ACGTT
#[3]     5 TCACC
كما يمكنك انشاء سلاسل فرعية من سلسلة ما دون اللجوء إلى عمل نسخ جديدة وذلك عن طريق استعمال النوافذ (Views), لهذه الخاصية أهمية كبيرة خاصة إذا كنت تتعامل مع سلسلة طويلة كسلسلة كروموزم من الكروموزومات.
في المثال التالي سوف نستعمل الكروموزوم 1 من الجينوم البشري (BSgenome.Hsapiens.UCSC.hg19) المتوفرة في حزمة BSgenome (اظافتا إلى جينومات الالكائنات النموذجية ( model organisms) ) وننشى نوافذ حول بعض الجينات التي نفرض أننا مهتمين بها.
library(Biostrings)
library(BSgenome.Hsapiens.UCSC.hg19)

#نأخذ الكروموزوم 1 كمثال
Hsapiens$chr1
#  249250621-letter "DNAString" instance
#seq: NNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNN...NNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNN

# لنفرض أننا مهتمين بسلسلة الجينات ABCA4, ACADM و GBA
genes <- Views(Hsapiens$chr1,
               start = c(93992836, 75724346, 155234447 ),
               end=c(94121148, 75763678, 155244861))
genes
#  Views on a 249250621-letter DNAString subject
#subject: NNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNN...NNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNNN
#views:
#        start       end  width
#[1]  93992836  94121148 128313 [AAATTGCTAACTGCTAGGGAAC...AATTAGCAAATACCTTTGCCTC]
#[2]  75724346  75763678  39333 [AGCGTTTGAGCTCCAATAAGGG...AACAACAACAAAAATGTCTCTT]
#[3] 155234447 155244861  10415 [TCTGGTGCTCGGTAATGGCGAG...GTGGCTCATGCCTGTAATCCCA]
بعدها يمكننا مثلا القيام بعمليات لحساب نسبة متتابعات الـ GC أو القيام بعملية الـ motif analysis لايجاد المتتابعات المتكررة.
واحدة من أهم الدوال التي توفرها حزمة Biostrings هي دوال مطابقة السلاسل نلخص بعضها في الجدول التالي:
| matchPattern , countPattern | لإيجاد مواضع تطابق سلسلة ما في سلسلة أخرى أو حساب عدد المطابقات (*v). |
| vmatchPattern, vcountPattern | إيجاد مواضع تطابقة سلسلة ما في مجموعة من السلاسل أو حساب عدد المطابقات في كل سلسلة (*v). |
| pairwiseAlignment | مطابقة سلسلتين باستعمال خوازمية Needleman-Wunsch للمطابقة الكلية و خوارزمية Smith-Waterman للمطابقة الجزئية |
| matchPWM , countPWM | المطابقة باستعمال مصفوفة أوزان (Pair-wise Weight Matrix) محددة من طرف المستعمل |
| matchPDict , countPDict | لإيجاد مواضع تطابق مجموعة من السلاسل في سلسلة أخرى أو حساب عدد المطابقات (*v). |
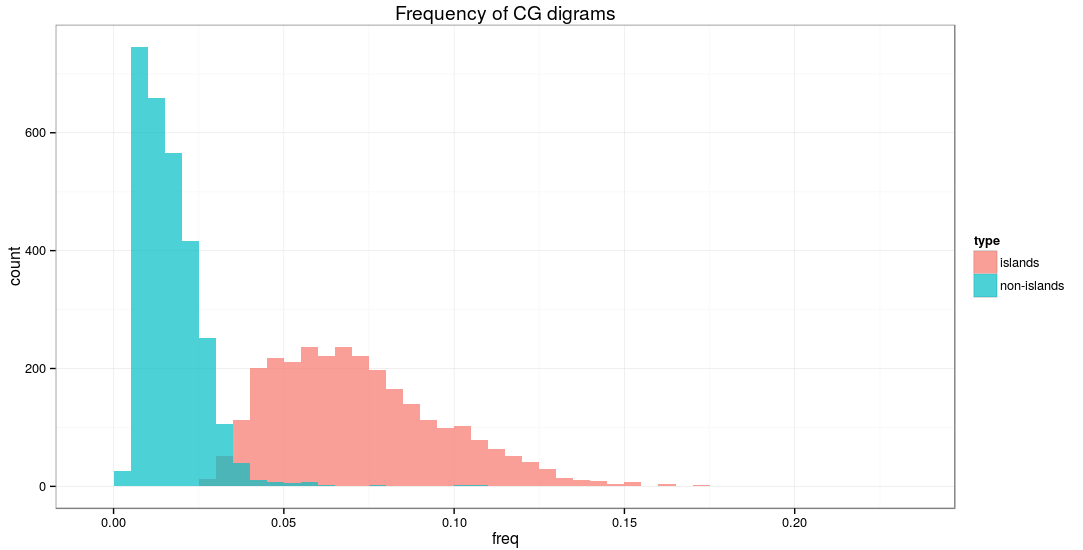
في المثال التالي سوف نستعمل مثال مقتبس من هذا الدرس, حيث نقوم باستعمال دالة vcountPattern لحساب نسبة تواجد سلاسل CG في مجموعتين من المناطق في الجينوم رقم 8. في العادة تتكتل سلاسل الـ CG بشكل غير عشوائي في مناطق تسمى جزر الـ GpC و التي تتواجد في العادة من القرب محفزات الجينات مما يجعلها ذات أهمية وظيفية.
# نقوم بتحميل مواقع جزر السي بي جي لكامل الجينوم
dataURL <-"http://bios221.stanford.edu/data/model-based-cpg-islands-hg19.txt"
cpglocs=read.table(dataURL ,header=T)

# نختار فقظ الكروموزم رقم 8
cpglocs8=cpglocs[which(cpglocs[,1]=="chr8"),2:3]

# الجدول يحتوي على أماكن بداية ونهاية كل جزيرة
head(cpglocs8)
#       start    end
#56961  32437  33708
#56962  40354  40656
#56963  44536  46203
#56964  99457 100721
#56965 155954 156761
#56966 179033 179756

# نقوم باخذ بعض المناطق التي لا تنتمي إلى الجزر
nonilocs8=matrix(0,ncol=2,nrow=2856)
nonilocs8[1,1]=10000
nonilocs8[1,2]=cpglocs8[1,1]-1
nonilocs8[2:2856,1]=cpglocs8[1:2855,2]+1
nonilocs8[2:2855,2]=cpglocs8[2:2855,1]-1
nonilocs8[2856,2]=146304021

head(nonilocs8)
#       [,1]   [,2]
#[1,]  10000  32436
#[2,]  33709  40353
#[3,]  40657  44535
#[4,]  46204  99456
#[5,] 100722 155953
#[6,] 156762 179032

# نقوم يتحميل الجينوم البشري
library(BSgenome.Hsapiens.UCSC.hg19)

# نحولها إلى سلاسل حمض نووي
seqChr8Islands = DNAStringSet(Hsapiens$chr8, start=cpglocs8[,1], end=cpglocs8[,2])
seqChr8NonIslands = DNAStringSet(Hsapiens$chr8, start=nonilocs8[,1], end=nonilocs8[,2])

seqChr8Islands

# A DNAStringSet instance of length 2855
#       width seq
#   [1]  1272 CGGGTGCCATCTCAGCAGCTCACGGTGTGGAA...TTTGCGGAAGAACACGGCGGGGGGGGCGGCGC
#   [2]   303 CGATTAGCGGGAGCGCAAAGCGAAGGGGCGGC...GCGCACGCGCGGTCGGCTCGGCGAGGAGCCGG
#   [3]  1668 CGGCGCTGCAGGAGAGGAGATGCCCAGGCCAG...CTCGGTGTGAGTTCATGGGTGTGACGGGGCGT
#   [4]  1265 CGGCTGGCCGGGCAGGGGGGCTGACCCCCCCC...TGAACTCCATCCTCCCGGCGGTCGGGCGGCGG
#   [5]   808 CGGGAAAGATTTTATTCACCGTCGATGCGGCC...CTCTTGCTCGCAGTATACTGGCGGCACGCCGC
#   ...   ... ...
#[2851]  2077 CGGCAAGTAGCACACTCGACCAACTGCTGAAA...ATTATTTCAAGGTCGACGGCCAAGGAGACCGG
#[2852]   472 CGACAGGCGGGAACGCCACCAGCCTGTGGGCG...TAGCCTCTCTAGATGGCGGGAGGCCGGGGCGA
#[2853]   902 CGCCACCCTCGCCCTGCCCGCGCCTCGGCCAA...GCGACCCGGGCAGGTGAGGAGCACGGGCCCGG
#[2854]   125 CGCCTCCAGCTGCGCAAGGGCAGGTGCGGGCA...GAGGATGCCTCAGTGCGTCCGGACACCACCGA
#[2855]  1631 CGTCTCAGGAAACACCGCTTTCCACTCCTGTG...ATCCACGGGCACGTGTGATCTGGGGTCCGCGG


# نقوم بحساب نسبة السلسلة سي جي في كل منطقة
freqIslands = vcountPattern("CG", seqChr8Islands) / width(seqChr8Islands)
freqNonIslands = vcountPattern("CG", seqChr8NonIslands) / width(seqChr8NonIslands)

# نضع هذه النتائج مع بعض في جدول
freqCombined = rbind(data.frame(freq = freqIslands, type = "islands"),
                     data.frame(freq = freqNonIslands, type = "non-islands"))

# السطور الأولى من الجدول
head(freqCombined)
#        freq    type
#1 0.09119497 islands
#2 0.09570957 islands
#3 0.05755396 islands
#4 0.08537549 islands
#5 0.10519802 islands
#6 0.06906077 islands


# ثم نقوم برسم الجدول التكراري لتوزع هذه النسب
library(ggplot2)
ggplot(freqCombined) +
  geom_histogram(aes(fill = type, x = freq), alpha = .7, position = "identity", binwidth = .005) +
labs(title = "Frequency of CG digrams") + theme_bw()من المخطط البياني نلاحظ أن نبسة الـ CG في الجزر أكبر بشكل ملحوظ من نظيرتها في المناطق الأخرى.
نكتفي في هذا المقال بهذا الجزء وسوف نحاول التعريف بحزم ودوال اخرى للتعامل مع السلاسل كدوال التعامل مع المجالات الجينومية و قراءة ملفات مثل FASTQ و BAM.