
مقدمة
السلام عليكم،
في عصر النماذج اللغوية الكبيرة (Large Language Models) والذكاء الاصطناعي التوليدي (Generative AI)، قد يتساءل البعض: هل لا تزال خوارزميات تعلم الآلة التقليدية (Machine Learning) ذات أهمية؟
الإجابة هي نعم. فعلى الرغم من التطور الكبير الذي شهدته النماذج اللغوية الكبيرة، لا تزال خوارزميات تعلم الآلة التقليدية تؤدي دورًا أساسيًا في تحليل البيانات العلمية، وخصوصًا في مجال المعلوماتية الحيوية (Bioinformatics). ففي كثير من التطبيقات، كتصنيف الأمراض، والتنبؤ بالاستجابة للعلاج، واكتشاف المؤشرات الحيوية (Biomarkers)، قد تكون نماذج مثل Random Forest وSupport Vector Machines وElastic Net أكثر ملاءمة من النماذج اللغوية الكبيرة، خاصة عندما نتعامل مع بيانات جزيئية منظمة (Structured Data) و عدد محدود نسبيًا من العينات.
ومع التطور المستمر لتقنيات الأوميكس (Omics)، أصبح بإمكان الباحثين قياس مستويات التعبير لعشرات الآلاف من الجينات، أو دراسة مثيلة الحمض النووي (DNA Methylation) في مئات الآلاف من المواقع الجينومية. وتتميز هذه البيانات غالبًا بوجود عدد كبير جدًا من المتغيرات مقارنة بعدد العينات، مما يجعل بناء نماذج دقيقة وقابلة للتعميم تحديًا إحصائيًا مهمًا.
تعتبر لغة بايثون من اللغات المستعملة في مجال تعلم الآلة، لكن لغة R تحتوي أيضًا على حزم شائعة جدًا في هذا المجال. وهنا تأتي أهمية منظومة Tidymodels في لغة R، التي توفر إطارًا متكاملًا ومرنًا لبناء نماذج تعلم الآلة، بدءًا من تجهيز البيانات واختيار المتغيرات، مرورًا بتدريب النماذج وتحسين معلماتها، وصولًا إلى تقييم أدائها وتفسير نتائجها.
في هذا المقال، سنتعرف على أهم مكونات Tidymodels من خلال مثال تطبيقي باستخدام بيانات حقيقية لمثيلة الحمض النووي من مشروع The Cancer Genome Atlas (TCGA)، وتحديدًا بيانات سرطان الكلى من نوع Kidney Renal Clear Cell Carcinoma (KIRC). سنستخدم بيانات معالجة مسبقًا، حتى نتمكن من التركيز على مراحل تعلم الآلة دون الحاجة إلى الدخول في تفاصيل معالجة ملفات المثيلة الخام.
1. ما هي منظومة Tidymodels؟
Tidymodels ليست خوارزمية تعلم آلة واحدة، بل مجموعة متكاملة من حزم R التي تعمل معًا لتسهيل بناء النماذج الإحصائية ونماذج تعلم الآلة. وبدلًا من الاعتماد على حزمة مختلفة لكل خوارزمية، توفر Tidymodels واجهة موحدة يمكن من خلالها تعريف النماذج، وإعداد البيانات، وتحسين المعلمات، وتقييم النتائج.
فمثلًا، إذا أردنا مقارنة الانحدار اللوجستي (Logistic Regression) ب Random Forest أو خوارزمية XGBoost، يمكننا استخدام البنية البرمجية نفسها مع تغيير تعريف النموذج فقط. وتتميز Tidymodels بتكاملها مع منظومة Tidyverse، مما يجعلها مألوفة للباحثين الذين يستخدمون حزمًا مثل dplyr وggplot2 في تحليل البيانات البيولوجية.
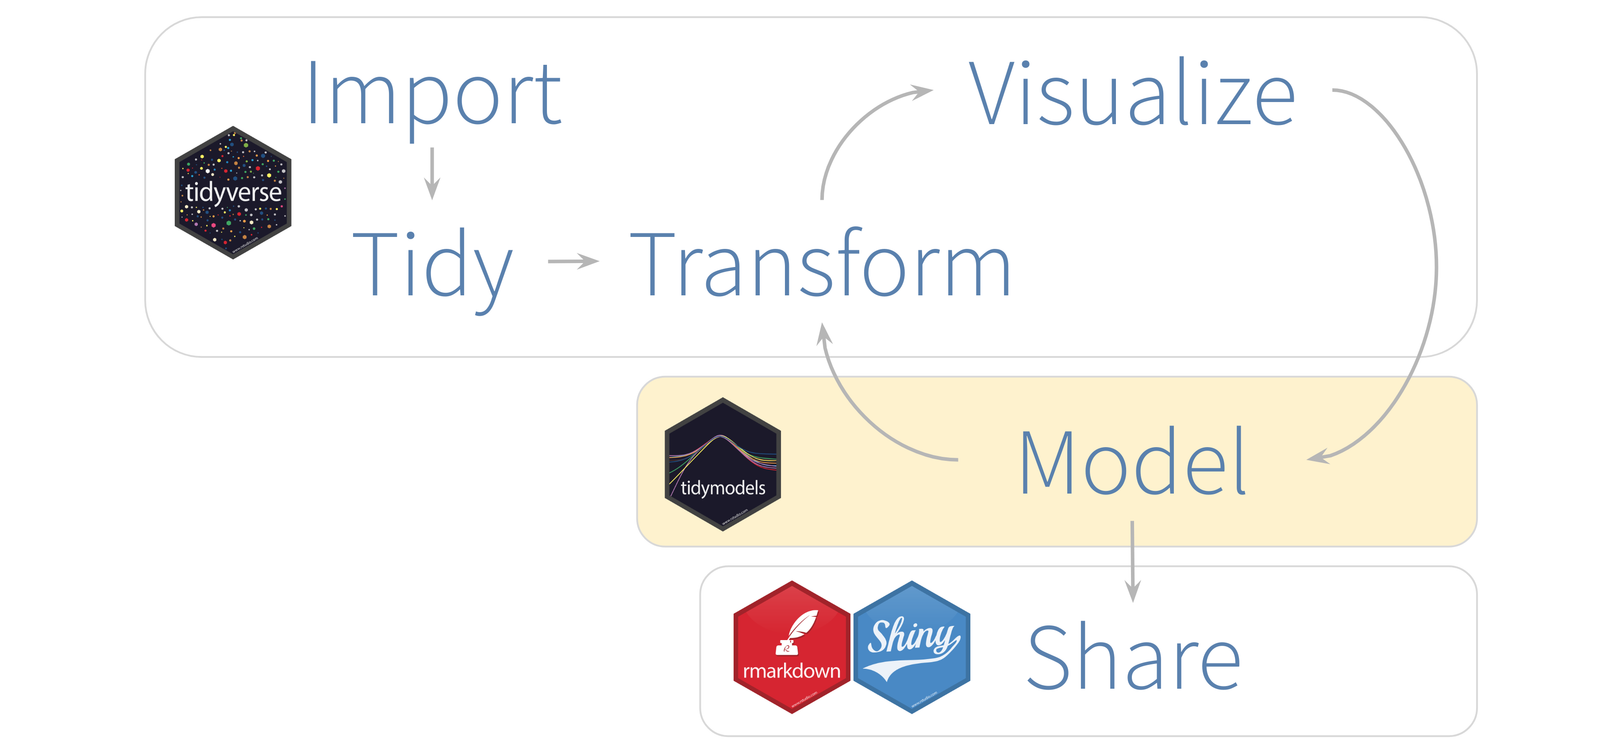
رسم بياني يوضح دور منظومة Tidymodels (المصدر)
أهم الحزم المكوّنة لمنظومة Tidymodels
|
الحزمة |
الوظيفة |
|---|---|
|
|
تقسيم البيانات إلى بيانات للتدريب وللاختبار |
|
|
تجهيز البيانات وتحويل المتغيرات واختيار الخصائص |
|
|
تعريف خوارزميات تعلم الآلة |
|
|
دمج مراحل تجهيز البيانات وتدريب النموذج |
|
|
تحسين المعلمات الفائقة (Hyperparameters) |
|
|
حساب مقاييس تقييم أداء النموذج |
|
|
تحديد نطاقات المعلمات واختيار قيمها |
تعمل هذه الحزم معًا لتشكيل مسار تحليل متكامل، كما هو موضح في المخطط التالي:
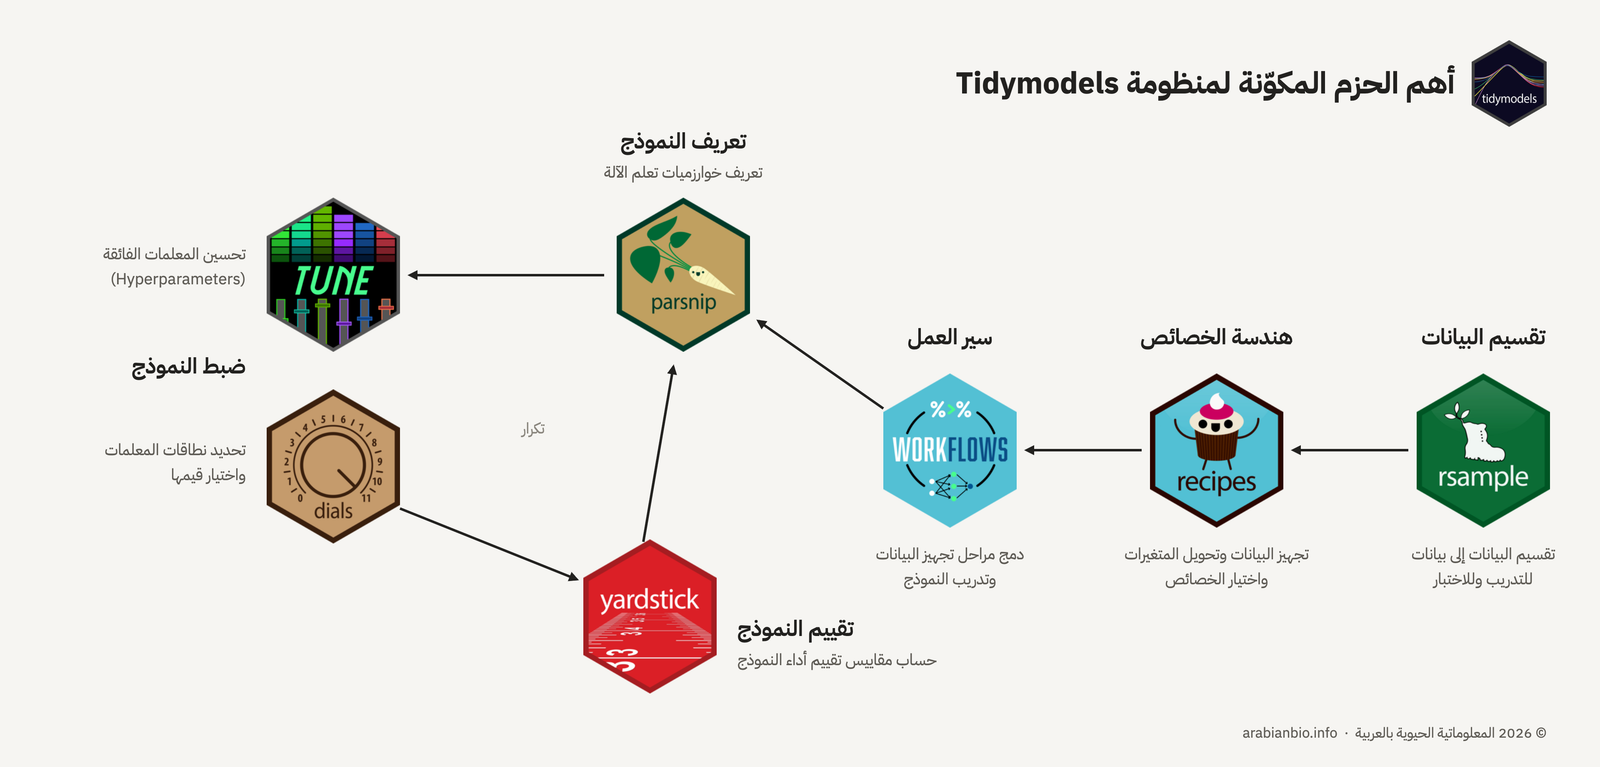
رسم تخطيطي لاهم الحزم المكونة ل Tidymodels
الميزة الأساسية لهذا التنظيم ليست فقط تقليل كمية الكود، وإنما أيضًا تقليل الأخطاء المنهجية، وخصوصًا تسرب المعلومات (Data Leakage) بين بيانات التدريب والتقييم.
2. مثال تطبيقي: التنبؤ بسرطان الثدي باستخدام DNA Methylation
لفهم كيفية عمل Tidymodels، سنستخدم بيانات مثيلة DNA من مشروع The Cancer Genome Atlas (TCGA)، الذي يوفر مجموعات واسعة من البيانات الجينومية والجزيئية لعدد كبير من أنواع السرطان. اخترنا سرطان الكلى لأن تغير أنماط المثيلة يمثل إحدى السمات الجزيئية المعروفة في الأورام.
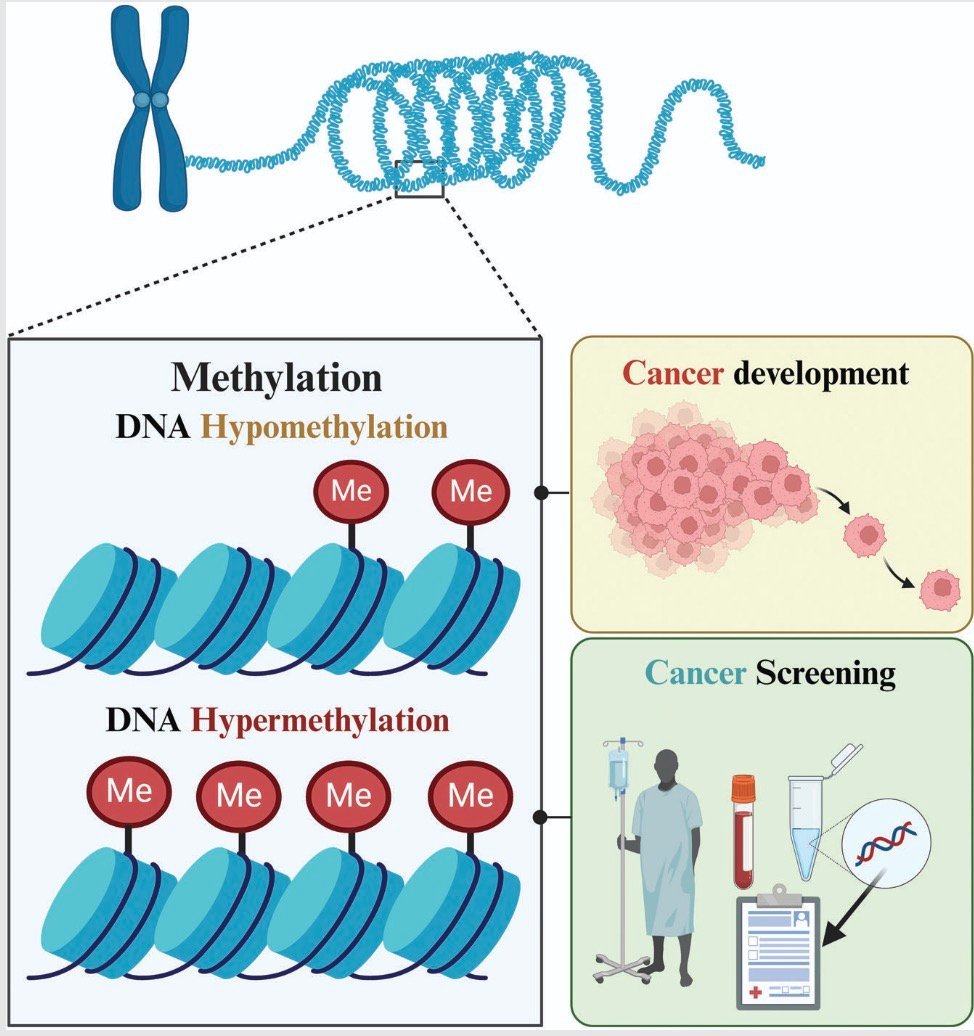
رسم بياني يبين دور ميثيلية DNA في امراض السرطان (المصدر)
ما هي مثيلة DNA؟
مثيلة الحمض النووي هي تعديل كيميائي يتضمن إضافة مجموعة ميثيل إلى الحمض النووي، وغالبًا ما تُدرس في عند مواقع ثنائية النوكليوتيد CpG. يمكن أن تؤثر هذه التعديلات في تنظيم التعبير الجيني دون تغيير تسلسل DNA نفسه، ولذلك تعد جزءًا مهمًا من علم التخلّق (Epigenetics). وتُستخدم مصفوفات Illumina، مثل HumanMethylation450K، لقياس مستويات المثيلة في مئات الآلاف من مواقع CpG.
عادةً ما يُعبّر عن مستوى المثيلة بقيمة تسمى Beta value، تتراوح بين صفر وواحد:
حيث يمثل M الإشارة المرتبطة بالمثيلة، و U الإشارة غير المرتبطة بالمثيلة، بينما alpha ثابت صغير يُستخدم لتفادي القسمة على صفر. كلما زادت قيمة beta فهذا يعني زيادة في الميثيلية. وقد ترتبط بعض هذه التغيرات الميثيلية بتنظيم الجينات أو عدم الاستقرار الجينومي أو اختلاف تركيب الخلايا داخل النسيج. لكن السؤال الذي يهمنا هنا هو: هل يمكن استخدام أنماط المثيلة عبر آلاف مواقع CpG للتمييز بين العينات الورمية والعينات الطبيعية؟
3. التعريف بمجموعة بيانات TCGA-KIRC
سنستخدم مجموعة بيانات KIRC المتاحة من خلال حزمة curatedTCGAData التابعة لمشروع Bioconductor. توفر هذه الحزمة بيانات جينومية وجزيئية معالجة مسبقًا من TCGA، بما في ذلك بيانات التعبير الجيني، ومثيلة DNA، والتغيرات الجينومية. وتتضمن مجموعة مثيلة KIRC المستخرجة من منصة HumanMethylation450K، و المتكونة من 480 عينة و 485,577 موقع CpG. أما الأعداد الدقيقة لكل فئة في النسخة المحمّلة، فسنتحقق منها باستخدام R.
تتميز هذه المجموعة بأنها أكبر بكثير من مجموعات المثيلة التعليمية الصغيرة، وتوفر عددًا مناسبًا من العينات لتوضيح خطوات التحقق المتقاطع وتحسين المعلمات. ومع ذلك، فهي لا تزال مجموعة بحثية محدودة مقارنة بعدد المتغيرات الكبير. يمكن الاطلاع على بيانات المشروع من خلال: TCGA-KIRC — curatedTCGAData
4. تثبيت الحزم وتحميل البيانات
لنبدأ بتثبيت الحزم المطلوبة:
install.packages(c("tidymodels", "glmnet", "ranger", "themis", "broom"))

if (!requireNamespace("BiocManager", quietly = TRUE))
  install.packages("BiocManager")

BiocManager::install(c("curatedTCGAData", "MultiAssayExperiment", "SummarizedExperiment"))
ثم نقوم بتفعيل الحزم:
library(tidymodels)
library(curatedTCGAData)
library(MultiAssayExperiment)
library(SummarizedExperiment)
library(dplyr)
library(ggplot2)
تحميل مجموعة TCGA-KIRC
سنستخدم الدالة curatedTCGAData() لتحميل بيانات مثيلة DNA.
kirc <- curatedTCGAData(
  diseaseCode = "KIRC",
  assays = "Methylation_methyl450",
  version = "2.0.1",
  dry.run = FALSE
)
من المهم هنا استخدام dry.run = FALSE، لأن القيمة الافتراضية للدالة تعرض جدولًا بالمجموعات المتاحة دون تحميل البيانات الفعلية. بعد التحميل، نستخرج مصفوفة المثيلة:
meth_se <- experiments(kirc)[[1]]
beta <- assay(meth_se)
dim(beta)
#485577 480
تمثل الصفوف مواقع CpG، بينما تمثل الأعمدة العينات البيولوجية. ويمكننا استعراض جزء من البيانات:
> beta[1:5,1:5]
<5 x 5> DelayedMatrix object of type "double":
           TCGA-3Z-A93Z-01A-11D-A36Y-05 TCGA-6D-AA2E-01A-11D-A36Y-05 TCGA-A3-3357-11A-01D-1418-05 TCGA-A3-3357-01A-02D-1418-05 TCGA-A3-3358-01A-01D-1536-05
cg00000029                   0.51427217                   0.66227604                   0.44396536                   0.56344634                   0.59782093
cg00000108                           NA                           NA                           NA                           NA                           NA
cg00000109                           NA                           NA                           NA                           NA                           NA
cg00000165                   0.08269327                   0.11136664                   0.12238595                   0.12869076                   0.11550211
cg00000236                   0.88720600                   0.89337874                   0.87835141                   0.92103059                   0.88847866
تحديد العينات السرطانية والطبيعية
تحتوي عينات TCGA على معلومات عن نوع العينة. ففي نظام ترميز TCGA، يشير الرمز 01 عادةً إلى عينة ورم أولي (Primary Tumor)، بينما يشير 11 إلى عينة نسيج طبيعي صلب (Solid Tissue Normal). يمكن استخراج هذه المعلومات مباشرة:
sample_ids <- colnames(beta)
sample_type <- substr(sample_ids, 14, 15)
table(sample_type)

#sample_type
# 01  05  11
# 319   1 160
يسمح هذا الكود بمعرفة العدد الفعلي للعينات الورمية والطبيعية في المجموعة التي حمّلناها.سنحتفظ فقط بنوعي العينات اللذين نحتاج إليهما:
keep <- sample_type %in% c("01", "11")
beta <- beta[, keep, drop = FALSE]
sample_ids <- sample_ids[keep]
sample_type <- sample_type[keep]
ومن المهم أيضًا الاحتفاظ بمعرف المريض، لأن بعض المرضى قد يمتلكون أكثر من عينة واحدة.
 patient_id <- substr(sample_ids, 1, 12)
 table(patient_id) |> table()

#   1   2
# 159 160
نلاحظ هنا ان هناك 160 مريض لديه عينتين. سنستخدم هذا المعرف لاحقًا لضمان عدم ظهور عينات المريض نفسه في مجموعتي التدريب والاختبار.
5. تجهيز البيانات وتقسيمها
تتوقع معظم خوارزميات تعلم الآلة أن تمثل الصفوف العينات، وأن تمثل الأعمدة المتغيرات. لكن مصفوفة المثيلة لدينا منظمة بالعكس، ولذلك سنقوم بقلبها. في البداية سنحتفظ بجميع مواقع CpG، لأن اختيار المواقع باستخدام MAD سيحدث لاحقًا داخل مسار التدريب.
سنخصص نحو 80% من البيانات للتدريب و20% للاختبار. كن إذا كانت هناك عينتان من المريض نفسه، فلا ينبغي أن تظهر إحداهما في التدريب والأخرى في الاختبار. لذلك سنستخدم دالة group_initial_split():
meth_data <- as_tibble(
  t(as.matrix(beta)),
  .name_repair = "minimal"
) |>
  mutate(
    PatientID = patient_id,
    Class = factor(
      if_else(sample_type == "01", "Tumor", "Normal"),
      levels = c("Tumor", "Normal")
    )
  )

  set.seed(123)

data_split <- group_initial_split(
  meth_data,
  group = PatientID,
  prop = 0.8
)

train_data <- training(data_split)
test_data <- testing(data_split)

table(train_data$Class)
 #Tumor Normal
 #  259    125

table(test_data$Class)
# Tumor Normal
#    60     35
6. اختيار مواقع CpG الأكثر تباينًا باستخدام MAD
تحتوي مجموعة البيانات الأصلية على أكثر من 485 ألف موقع CpG، بينما لا يتجاوز عدد العينات بضع مئات. وهذه إحدى المشكلات الأساسية في المعلوماتية الحيوية، حيث يكون عدد المتغيرات أكبر بكثير من عدد العينات. عند استخدام هذا العدد الكبير من المتغيرات، قد يصبح تدريب النموذج مكلفًا من الناحية الحاسوبية، كما تزداد احتمالية overfitting. ولهذا سنقوم بتقليل عدد المتغيرات قبل تدريب النموذج. لكن بدلًا من اختيار مجموعة عشوائية من مواقع CpG، سنستخدم Median Absolute Deviation (MAD) لاختيار المواقع التي تظهر أكبر قدر من التباين بين العينات.
يقيس MAD مقدار تشتت القيم حول وسيطها، ويُحسب وفق المعادلة التالية:
ويتميز MAD بأنه أقل تأثرًا بالقيم المتطرفة (Outliers) مقارنة بالانحراف المعياري.
نقطة منهجية مهمة: متى نحسب MAD؟
رغم أن MAD مقياس غير خاضع للإشراف (Unsupervised)، أي أنه لا يستخدم حالة المرض أو التصنيف، فإن حسابه على جميع العينات قبل تقسيمها قد يؤدي إلى تسرب المعلومات. فإذا اخترنا أفضل 5000 موقع باستخدام جميع العينات، فإن عينات الاختبار تكون قد أثرت في تحديد الخصائص المستخدمة في النموذج. ولهذا يجب حساب MAD باستخدام بيانات التدريب فقط.
سنستخدم حزمة matrixStats، التي توفر دوال سريعة لحساب الإحصاءات على المصفوفات الكبيرة.
library(matrixStats)

cpg_cols <- setdiff(names(train_data), c("PatientID", "Class"))

cpg_mad <- colMads(as.matrix(train_data[, cpg_cols]), na.rm = TRUE)

top_cpgs <- cpg_cols[order(cpg_mad, decreasing = TRUE)[1:5000]]

train_data <- training(data_split) |>
  select(PatientID, all_of(top_cpgs), Class)

test_data <- testing(data_split) |>
  select(PatientID, all_of(top_cpgs), Class)

dim(train_data)
#384 5002

dim(test_data)
#95	5002
هل المواقع الأكثر تباينًا هي بالضرورة الأكثر ارتباطًا بالمرض؟
ليس بالضرورة. فقد تعكس الاختلافات في مستويات المثيلة عوامل بيولوجية أخرى، مثل العمر أو تركيب الخلايا، أو عوامل تقنية مرتبطة بتجهيز العينات.
لكن اختيار المواقع باستخدام MAD يوفر طريقة بسيطة وغير خاضعة للإشراف (Unsupervised Feature Selection) لتقليل عدد المتغيرات قبل تدريب النموذج.
intersect(
  unique(train_data$PatientID),
  unique(test_data$PatientID)
)
7.إنشاء وصفة تجهيز البيانات
بعد اختيار أكثر 5000 موقع CpG تباينًا باستخدام مقياس MAD، أصبحت لدينا مجموعة بيانات أصغر يمكن استخدامها لتدريب نماذج تعلم الآلة. لكن قبل البدء بالتدريب، قد تحتاج البيانات إلى بعض المعالجة الإضافية، مثل التعامل مع القيم المفقودة، وإزالة المتغيرات ذات التباين الصفري، وتوحيد مقاييس المتغيرات. توفر حزمة recipes إحدى أهم الأدوات داخل منظومة Tidymodels، حيث تسمح بتجميع خطوات تجهيز البيانات (Data Preprocessing) في وصفة واحدة يمكن إعادة استخدامها مع خوارزميات تعلم آلة مختلفة.
سننشئ وصفة تتضمن ثلاث خطوات أساسية:
meth_recipe <- recipe(Class ~ ., data = train_data) |>
  update_role(PatientID, new_role = "id variable") |>
  step_impute_median(all_numeric_predictors()) |>
  step_zv(all_numeric_predictors()) |>
  step_normalize(all_numeric_predictors())
تؤدي كل خطوة وظيفة محددة:
- تعويض القيم المفقودة باستخدام الوسيط لكل موقع CpG :
step_impute_median - إزالة المتغيرات منعدمة التباين، التي لا تقدم معلومات مفيدة للتصنيف:
step_zv - توحيد المتغيرات بحيث يصبح متوسطها صفرًا وانحرافها المعياري واحدًا:
step_normalize
من المميزات المهمة لحزمة recipes أنها لا تطبق خطوات التجهيز مباشرة عند تعريف الوصفة، بل تحتفظ بالتعليمات ليتم تنفيذها لاحقًا أثناء تدريب النموذج. وعند استخدام الوصفة ضمن workflows، تُحسب المعلمات اللازمة للتجهيز باستخدام بيانات التدريب فقط، ثم تُطبق التحويلات نفسها على العينات الجديدة. وهذا يساعد على تجنب تسرب المعلومات (Data Leakage). والأهم أننا سنستخدم وصفة التجهيز نفسها مع خوارزميات مختلفة، مما يسهل مقارنة أدائها دون الحاجة إلى إعادة كتابة خطوات تجهيز البيانات لكل نموذج.
8. تعريف نماذج تعلم الآلة باستخدام Parsnip
بعد تجهيز البيانات، ننتقل إلى اختيار خوارزميات تعلم الآلة. توفر حزمة parsnip واجهة موحدة لتعريف النماذج، بحيث يمكننا الانتقال بين خوارزميات مختلفة دون الحاجة إلى تعلم طريقة برمجة مستقلة لكل منها. في مثالنا، سنجرب نموذجين شائعين في تحليل البيانات البيولوجية: Elastic Net وRandom Forest.
elastic_model <- logistic_reg(
  penalty = tune(),
  mixture = tune()
) |>
  set_engine("glmnet") |>
  set_mode("classification")


rf_model <- rand_forest(
  mtry = tune(),
  trees = tune(),
  min_n = tune()
) |>
  set_engine("ranger") |>
  set_mode("classification")
وتشير tune() هنا إلى أننا سنبحث عن أفضل القيم لهذه المعلمات باستخدام التحقق المتقاطع (cross-validation). من المهم هنا الاشارة أن النموذجين يختلفان من الناحية الرياضية، لكننا استخدمنا طريقة متشابهة لتعريفهما، وهي إحدى المزايا الرئيسية لحزمة parsnip.
9. إنشاء مجموعة مسارات تعلم الآلة باستخدام Workflowsets
بعد إنشاء وصفة تجهيز البيانات (meth_recipe) وتعريف نموذجي Elastic Net وRandom Forest، نحتاج إلى دمج هذه العناصر من أجل تدريب النماذج ومقارنة أدائها. توفر حزمة workflowsets طريقة سهلة لتنظيم عدة نماذج تعلم آلة ضمن مجموعة واحدة، بدلًا من إنشاء Workflow منفصل لكل خوارزمية. وتتميز هذه الحزمة بإمكانية استخدام وصفة تجهيز بيانات واحدة مع عدة نماذج، ثم تدريبها وتحسين معلماتها ومقارنة نتائجها باستخدام مجموعة موحدة من الدوال.
library(workflowsets)

model_workflows <- workflow_set(
  preproc = list(meth = meth_recipe),
  models = list(
    elastic_net = elastic_model,
    random_forest = rf_model
  )
)

model_workflows$wflow_id
# "meth_elastic_net" "meth_random_forest"
ستقوم workflow_set() تلقائيًا بإنشاء مسارين، يجمع كل منهما وصفة تجهيز البيانات بأحد النموذجين. ومن المميزات المهمة لهذه الطريقة أنه يمكننا إضافة خوارزميات أخرى لاحقًا، مثل SVM أو XGBoost، بمجرد إضافتها إلى قائمة models، دون الحاجة إلى إعادة كتابة خطوات تجهيز البيانات.
10. التحقق المتقاطع وتحسين معلمات النماذج
بعد إنشاء مسارات التحليل، نحتاج إلى تقييم النماذج وتحديد المعلمات التي تحقق أفضل أداء. سنستخدم التحقق المتقاطع بخمس طيات (5-fold Cross-Validation)، مع المحافظة قدر الإمكان على نسبة العينات الورمية والطبيعية داخل كل طية.
set.seed(123)

cv_folds <- group_vfold_cv(
  train_data,
  group = PatientID,
  v = 5,
  repeats = 3,
  balance = "observations"
)
11. تدريب النماذج باستخدام Workflowsets
بعد إنشاء مجموعة مسارات التحليل، يمكننا تدريب جميع النماذج وتحسين معلماتها باستخدام الدالة workflow_map(). سنستخدم طيات التحقق المتقاطع (cv_folds) التي أنشأناها سابقًا، ونطبقها على النموذجين لضمان مقارنة عادلة. في كل طية، يُدرّب النموذج على جزء من بيانات التدريب، ثم يُقيّم على الجزء المتبقي. وتتكرر العملية ثلاث مرات للحصول على تقدير أكثر استقرارًا للأداء.
تقوم workflow_map() بتنفيذ tune_grid() على جميع النماذج الموجودة في المجموعة، مع الاحتفاظ بنتائج تحسين المعلمات لكل نموذج.
#library(future)
#
#plan(multisession, workers = 4)

workflow_results <- model_workflows |>
  workflow_map(
    fn = "tune_grid",
    resamples = cv_folds,
    grid = 20,
    metrics = metric_set(roc_auc, accuracy, mcc),
    control = control_grid(parallel_over = "everything"),
    verbose = TRUE,
    seed = 123
  )
مقارنة أداء النماذج
بعد انتهاء التدريب، يمكننا ترتيب النماذج حسب ROC-AUC باستخدام:
 rank_results(
  workflow_results,
  rank_metric = "roc_auc",
  select_best = TRUE
)
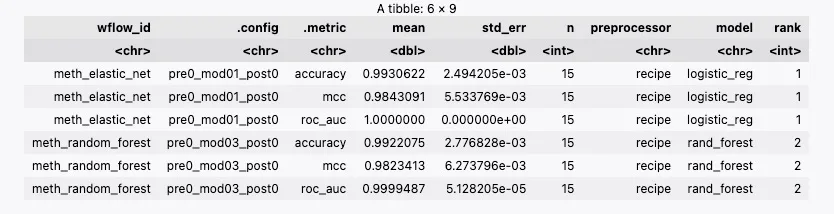
ذه النتائج ممتازة، لكن عندما نحصل على ROC-AUC تقترب من الواحد، ينبغي أن نسأل سؤالًا مهمًا: هل يتعلم النموذج بالفعل اختلافات بيولوجية قوية، أم أنه يعاني من فرط التكيّف (overfitting)؟
للإجابة عن هذا السؤال، سنبدأ بتقييم النموذج على مجموعة الاختبار test_data التي احتفظنا بها منذ البداية.
12. تقييم النموذج النهائي على بيانات الاختبار
بعد تحسين المعلمات، سنختار النموذج الأفضل بناءً على متوسط ROC-AUC أثناء التحقق المتقاطع. يمكن تنفيذ ذلك باستخدام:
ranking <- rank_results(
  workflow_results,
  rank_metric = "roc_auc",
  select_best = TRUE
)

best_id <- ranking$wflow_id[1]

best_results <- extract_workflow_set_result(workflow_results, best_id)
best_workflow <- extract_workflow(workflow_results, best_id)

best_params <- select_best(best_results, metric = "roc_auc")

final_workflow <- finalize_workflow(best_workflow, best_params)

final_model <- fit(final_workflow, data = train_data)
بعد ذلك، نستخدم النموذج النهائي للتنبؤ بحالة العينات الموجودة في مجموعة الاختبار المستقلة و نعاين الأداء:
test_predictions <- bind_cols(
  test_data |> select(Class),
  predict(final_model, new_data = test_data),
  predict(final_model, new_data = test_data, type = "prob")
)
roc_auc(test_predictions, truth = Class, .pred_Tumor)
accuracy(test_predictions, truth = Class, estimate = .pred_class)
mcc(test_predictions, truth = Class, estimate = .pred_class)
conf_mat(test_predictions, truth = Class, estimate = .pred_class)
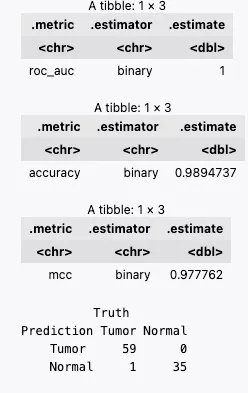
تمكن النموذج من تصنيف 94 عينة بصورة صحيحة من أصل 95 عينة. تُشير هذه النتائج إلى أن أنماط مثيلة DNA تحتوي على معلومات قوية تسمح بالتمييز بين الأنسجة الورمية والأنسجة الطبيعية المجاورة في مجموعة TCGA-KIRC. ومن الملاحظ أيضًا أن أداء النموذج على بيانات الاختبار بقي قريبًا جدًا من أدائه أثناء التحقق المتقاطع، وهو أمر مطمئن من ناحية قدرته على التعميم داخل المجموعة البحثية نفسها. لكن هذه النتائج لا تعني بالضرورة أن النموذج صالح للاستخدام السريري؛ إذ ما زلنا بحاجة إلى تقييمه على مجموعة مستقلة من مصدر مختلف.
13. لماذا حققت النماذج هذه الدقة المرتفعة؟
قد تبدو دقة تصنيف تتجاوز 98% مرتفعة بصورة غير معتادة، خصوصًا عند استخدام بيانات جزيئية تحتوي على آلاف المتغيرات. لكن من المهم أن نتذكر أننا لا نحاول التنبؤ بمستقبل المرض أو الاستجابة لعلاج معين، وإنما نحاول التمييز بين نسيج ورمي ونسيج طبيعي مجاور له. ومن المعروف أن السرطان يرتبط بتغيرات واسعة في تنظيم الجينوم، بما في ذلك أنماط مثيلة DNA. ولفهم سبب ارتفاع الأداء في تجربتنا، يمكننا فحص البيانات نفسها قبل الاعتماد على نتائج نماذج تعلم الآلة.
بما أننا اخترنا أعلى 5000 موقع CpG تباينًا باستخدام MAD، فقد نتساءل عما إذا كان الأداء المرتفع للنموذج ناتجًا عن هذا الاختيار أم عن اختلافات بيولوجية حقيقية بين العينات الورمية والطبيعية. لاستكشاف ذلك، سنستخدم تحليل المكونات الرئيسية (PCA) لرسم توزيع العينات باستخدام أعداد مختلفة من مواقع CpG، ومعرفة مدى تأثير عدد المواقع المختارة في الفصل بين المجموعتين.
mad_sizes <- c(50, 100,500, 1000, 5000, 10000, 20000,25000)

## we calculate PCA for each top MAD CpGs.
pca_results <- map_dfr(mad_sizes, function(n) {

  selected_cpgs <- head(mad_order, n)
  x <- as.matrix(train_full[, selected_cpgs, drop = FALSE])

  # Replace infinite values with NA
  x[!is.finite(x)] <- NA_real_

  # Impute missing values using each CpG's median
  medians <- colMedians(x, na.rm = TRUE)

  # Remove CpGs without a valid median
  valid <- is.finite(medians)
  x <- x[, valid, drop = FALSE]
  medians <- medians[valid]

  for (j in seq_len(ncol(x))) {
    x[is.na(x[, j]), j] <- medians[j]
  }

  # Remove zero-variance CpGs before scaling
  sds <- colSds(x)
  x <- x[, is.finite(sds) & sds > 0, drop = FALSE]

  # PCA
  pca <- prcomp(x, center = TRUE, scale. = TRUE)

  var_exp <- pca$sdev^2 / sum(pca$sdev^2)

  tibble(
    Class = train_full$Class,
    PatientID = train_full$PatientID,
    n_CpGs = paste0("Top ", format(n, big.mark = ","), " MAD CpGs"),
    PC1 = pca$x[, 1],
    PC2 = pca$x[, 2],
    PC1_var = var_exp[1],
    PC2_var = var_exp[2]
  )
})

## plot
pca_results$n_CpGs = factor(pca_results$n_CpGs, levels = unique(pca_results$n_CpGs))

ggplot(pca_results, aes(x = PC1, y = PC2, color = Class)) +
  geom_point(size = 2.5, alpha = 0.8) +
  facet_wrap(~ n_CpGs, scales = "free") +
  labs(
    title = "PCA of Training Samples Using Different Numbers of Top MAD CpGs",
    x = "PC1",
    y = "PC2"
  ) +
  scale_color_manual(values = c("Tumor" = "#fdb462", "Normal" = "#a6cee3")) +
  theme_bw(base_size = 12)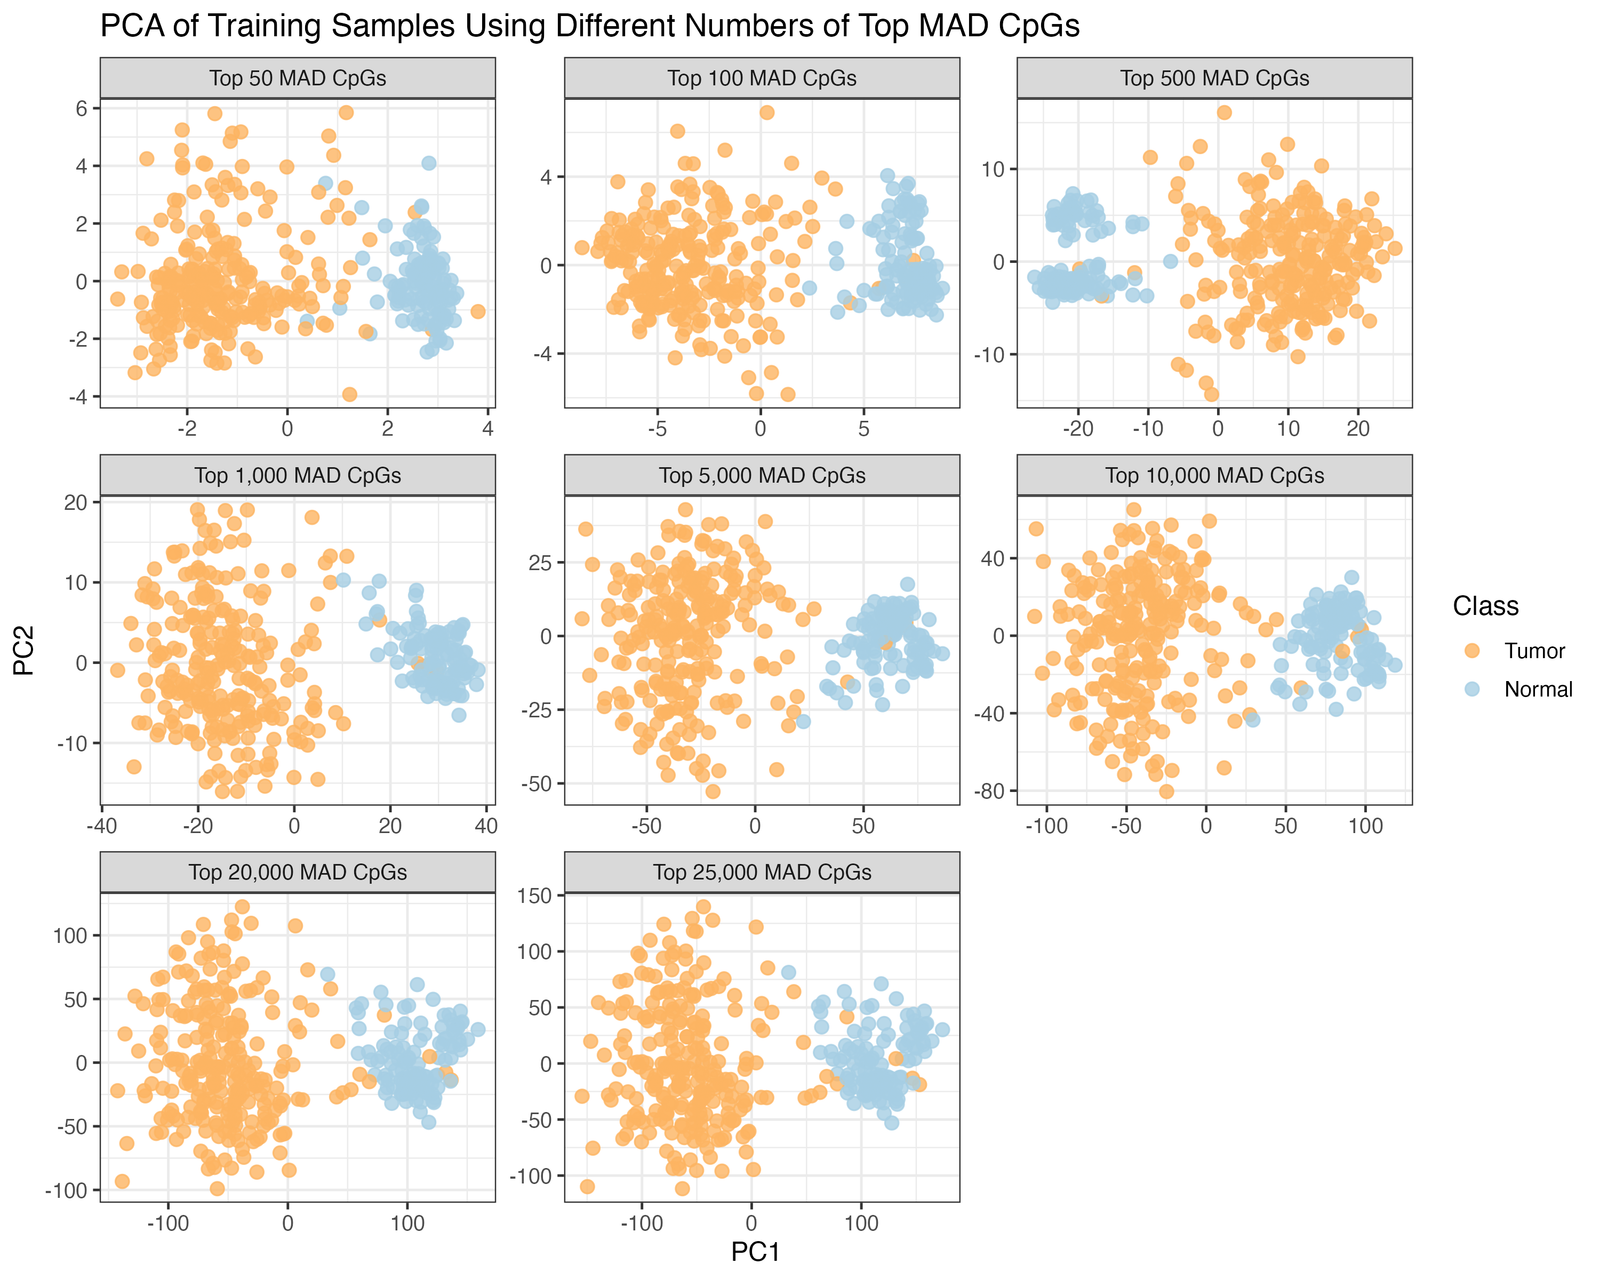
أظهر التحليل وجود اختلاف واضح بين العينات الورمية والطبيعية. فعند استخدام 50 أو 100 موقع CpG، كان هناك تداخل ملحوظ بين المجموعتين. لكن عند زيادة العدد إلى 500 أو 1000 موقع، أصبح الفصل أكثر وضوحًا. تساعدنا هذه النتيجة على فهم سبب تحقيق نماذج تعلم الآلة أداءً مرتفعًا؛ إذ إن اختلافات المثيلة بين المجموعتين تظهر حتى باستخدام طرق استكشافية لا تعتمد على معرفة الحالة المرضية أثناء حساب المكونات الرئيسية.
لكن النتائج لا تزال تحتاج إلى تحقق خارجي قبل الحديث عن إمكانية تعميمها على مجموعات مرضى أخرى.
الخلاصة
في عصر الذكاء الاصطناعي التوليدي والنماذج اللغوية الكبيرة، لا تزال خوارزميات تعلم الآلة التقليدية تؤدي دورًا مهمًا في المعلوماتية الحيوية، وخصوصًا عند تحليل البيانات الجزيئية المنظمة وعالية الأبعاد. توفر منظومة Tidymodels في لغة R إطارًا مرنًا ومتكاملًا لبناء نماذج تعلم الآلة بطريقة منظمة وقابلة لإعادة الإنتاج.
لكن الدرس الأهم من هذا المثال هو أن نجاح تعلم الآلة لا يعتمد على اختيار الخوارزمية وحدها، بل على فهم طبيعة البيانات، واختيار الخصائص المناسبة، وتجنب تسرب المعلومات، وتصميم استراتيجية تحقق سليمة، وتفسير النتائج في سياقها البيولوجي.
فالنموذج الجيد ليس بالضرورة الأكثر تعقيدًا، وإنما النموذج الذي يقدم تنبؤات موثوقة وقابلة للتكرار والتفسير.
المراجع والمصادر
- Tidymodels — الموقع الرسمي
- Tidy Modeling with R — كتاب مجاني
- curatedTCGAData — Bioconductor
- TCGA-KIRC — وصف مجموعة البيانات
- Recipes — تجهيز البيانات
- Workflowsets — مقارنة نماذج تعلم الآلة
- rsample — تقسيم البيانات والتحقق المتقاطع
- Tune — تحسين معلمات النماذج
- Yardstick — تقييم أداء نماذج تعلم الآلة
- matrixStats — عمليات إحصائية على المصفوفات